FlexDM과 FlexDM-LoRA: 생성하지 않고 읽어서 판단하기
Jev의 등장
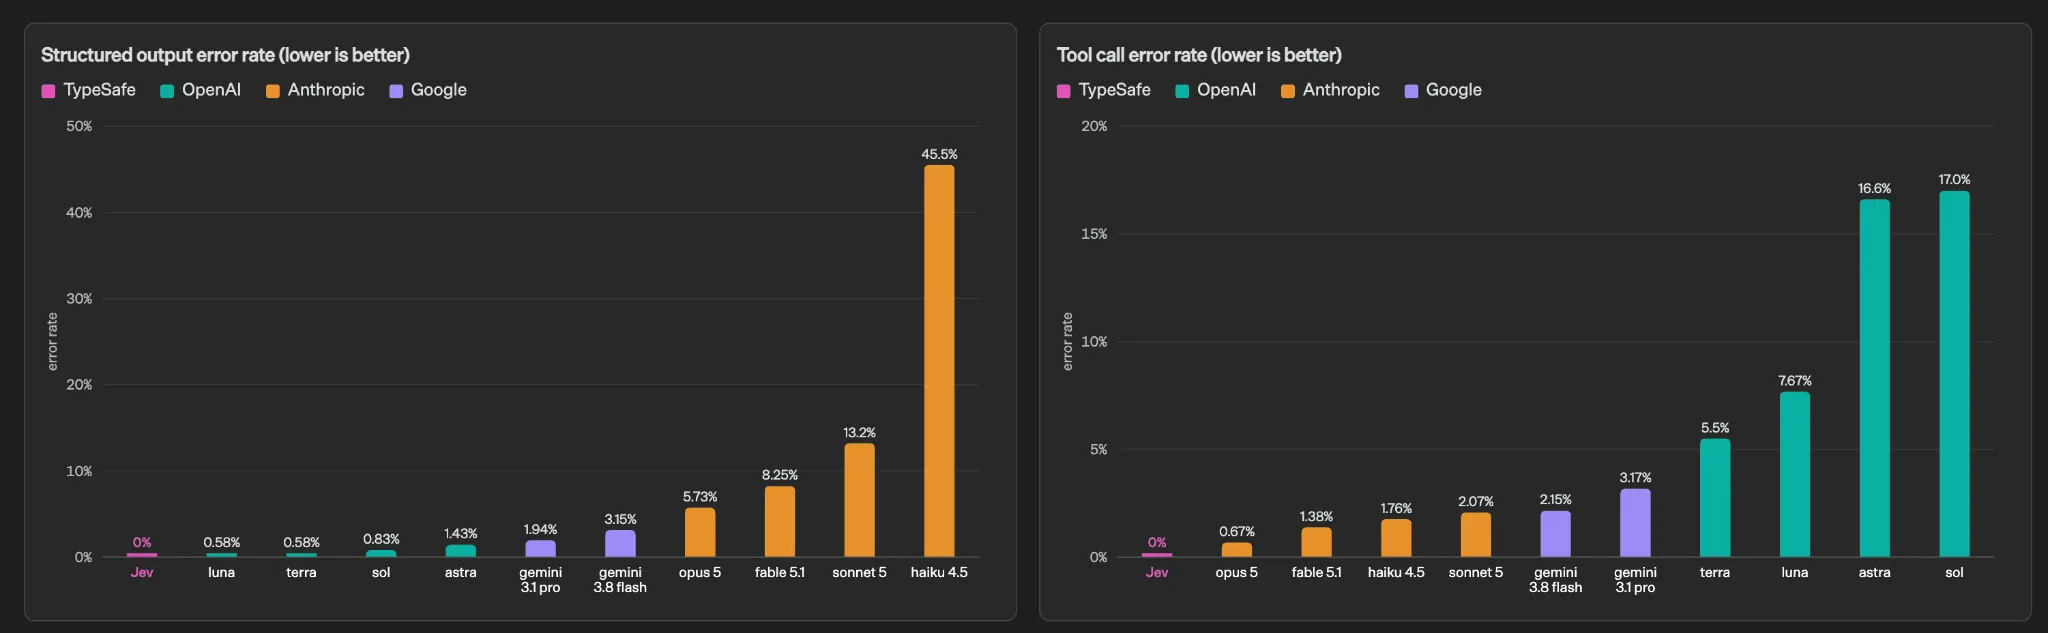
2026년 9월 15일, TypeSafe AI가 ‘System One 모델’이라는 새 분류와 그 첫 모델 Jev를 발표했다 (발표 글). 문제의식은 이렇다. 채팅형 언어 모델은 몇 년째 똑똑해졌는데, 그만큼 일을 자동화하지는 못했다. 모델이 내놓는 것이 글이라서, 프로그램이 쓰려면 매번 파싱하고 검증해야 한다. 그 과정에서 비용과 지연이 늘고, 형식이 어긋나 흐름이 끊기기도 한다.
이름은 대니얼 카너먼의 『생각에 관한 생각(Thinking, Fast and Slow)』에서 왔다. 사람의 생각에는 빠르고 직관적인 시스템 1과 느리고 신중한 시스템 2가 있다. 길게 생각한 뒤 답하는 추론 모델이 시스템 2에 가깝다면, Jev는 시스템 1처럼 작은 판단을 빠르게 내리는 데 집중한다.
TypeSafe가 밝힌 Jev의 특징은 이렇다.
- 글을 생성하지 않는다. 모든 답을 한 번의 병렬 계산으로 낸다.
- 응답 시간은 처음부터 끝까지 70~500ms다. System One 형태의 질문에서는 최신 대형 모델보다 40~200배 빠르다고 했다.
- 입력 100만 토큰에 0.042달러이고, 출력에는 값을 받지 않는다.
- 모든 답에 보정된 확률이 붙는다. 미리 정한 보기 밖의 답을 내는 형식 오류가 원리상 없다.
- 학습 방법은 RLCD(Reinforcement Learning for Calibrated Decisions)라고만 밝혔다. 사람의 선호(RLHF)나 정답 여부(RLVR)가 아니라, 정직한 확률을 내는 답에 보상을 준다는 뜻이다. 데이터와 구조는 공개하지 않았다.
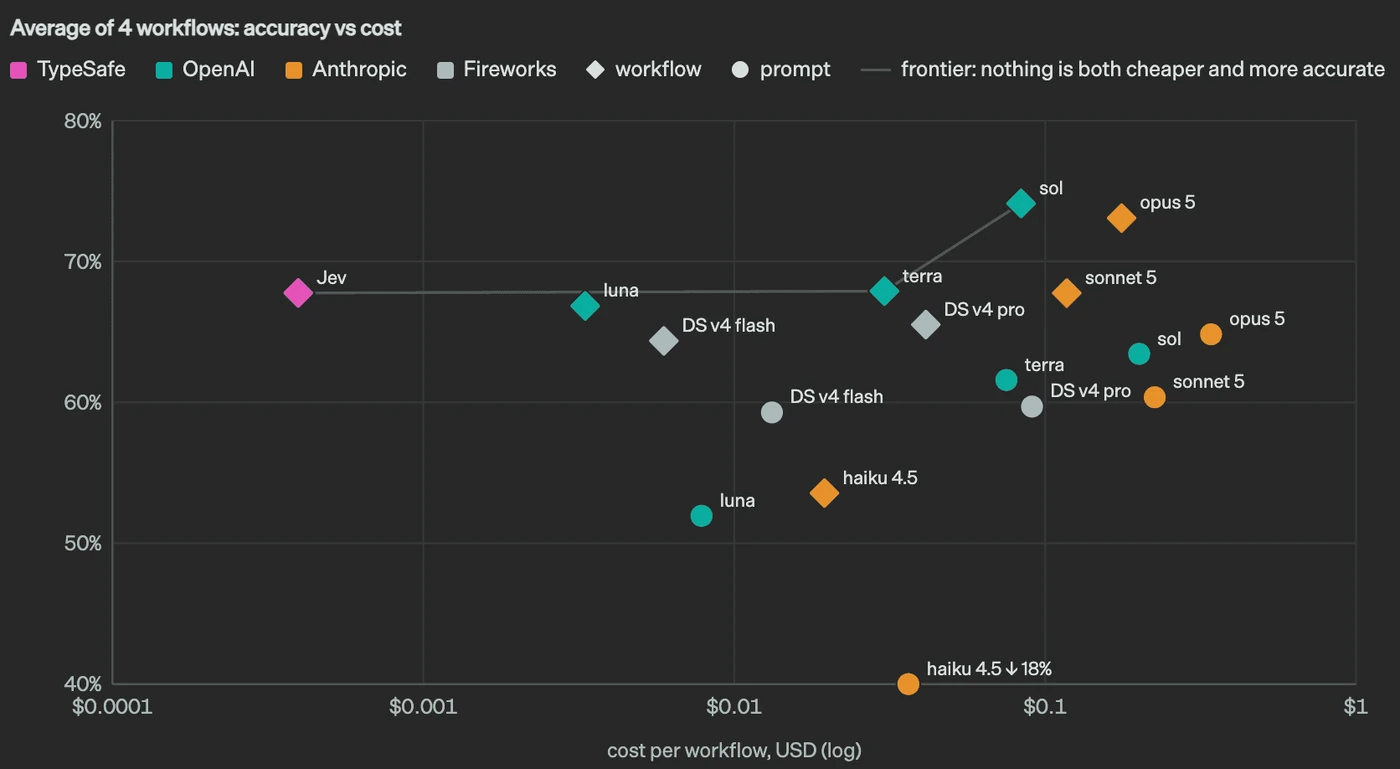
Jev는 API로만 쓸 수 있고 가중치는 공개되지 않았다. 독립 평가 논문(arXiv 2609.37647)은 분류, 라우팅, 콘텐츠 검수, 기준표 채점에 걸친 37개 데이터셋에서 Jev를 학습 없이 재 봤다. Jev는 27개 데이터셋에서 Qwen3.8-27B를, 37개 모두에서 Gemma-4-E4B를 앞섰고, 보기 확률도 잘 보정돼 있었다. 다만 저자원 언어, 잡음이 많은 라벨, 기준표 채점은 세 모델 모두 어려워했고, 여러 단계로 이어지는 게임 과제에서 Jev는 효과 없는 행동을 되풀이하기도 했다.
System One 모델은 무엇을 하나
채팅형 언어 모델은 글을 한 토큰씩 만들고, 프로그램이 그것을 파싱·검증한다. 형식이 어긋나면 다시 생성한다. System One 모델은 타입이 정해진 질문을 받아 한 번의 판독으로 보기마다 확률을 낸다(예: billing 0.57).
- 상태
- 질문
System One 모델은 ‘상태’와 ‘타입이 정해진 질문’을 받아, 질문마다 정해진 형식의 답과 확률을 돌려준다. 상태는 문서, 대화, 메일, 기기 목록처럼 무엇이든 될 수 있다. 질문의 타입은 세 가지다.
| 타입 | 묻는 것 | 돌려주는 것 |
|---|---|---|
choice |
정해진 보기 중 무엇인가 | 고른 보기와 보기마다의 확률 |
noul |
어떤 진술이 참인가 | 참일 확률 |
score |
정해진 척도의 몇 단계인가 | 단계마다의 확률 |
예를 들어 고객 문의를 나누는 프로그램은 이렇게 묻는다(필드 일부를 줄인 예시다).
{
  "state": "주문한 노트북이 일주일째 안 왔어요. 카드 결제도 두 번 된 것 같습니다.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "이 문의를 어느 팀에 보낼까?",
      "criteria": {
        "shipping": "배송 지연, 분실",
        "billing": "결제, 환불",
        "tech": "제품 고장, 사용법"
      }
    },
    "urgent": {
      "type": "noul",
      "instructions": "오늘 안에 답해야 하는 문의인가?",
      "criteria": { "true": "금전 피해나 마감이 걸려 있다", "false": "그렇지 않다" }
    }
  }
}
답은 이런 모양이다.
{
  "team":   { "type": "choice", "choice": "billing",
              "probabilities": { "shipping": 0.38, "billing": 0.57, "tech": 0.05 } },
  "urgent": { "type": "noul", "noul": 0.81 }
}
프로그램은 답을 파싱하지 않고 그대로 분기에 쓴다. 확률이 정직하면 쓸모가 더 커진다. ‘billing 0.57’처럼 애매한 판단만 사람에게 넘기고, 확신이 높은 판단은 자동으로 처리할 수 있다. 그래서 System One 모델에서는 정답률만큼 확률의 보정이 중요하다.
Jev Decision Index
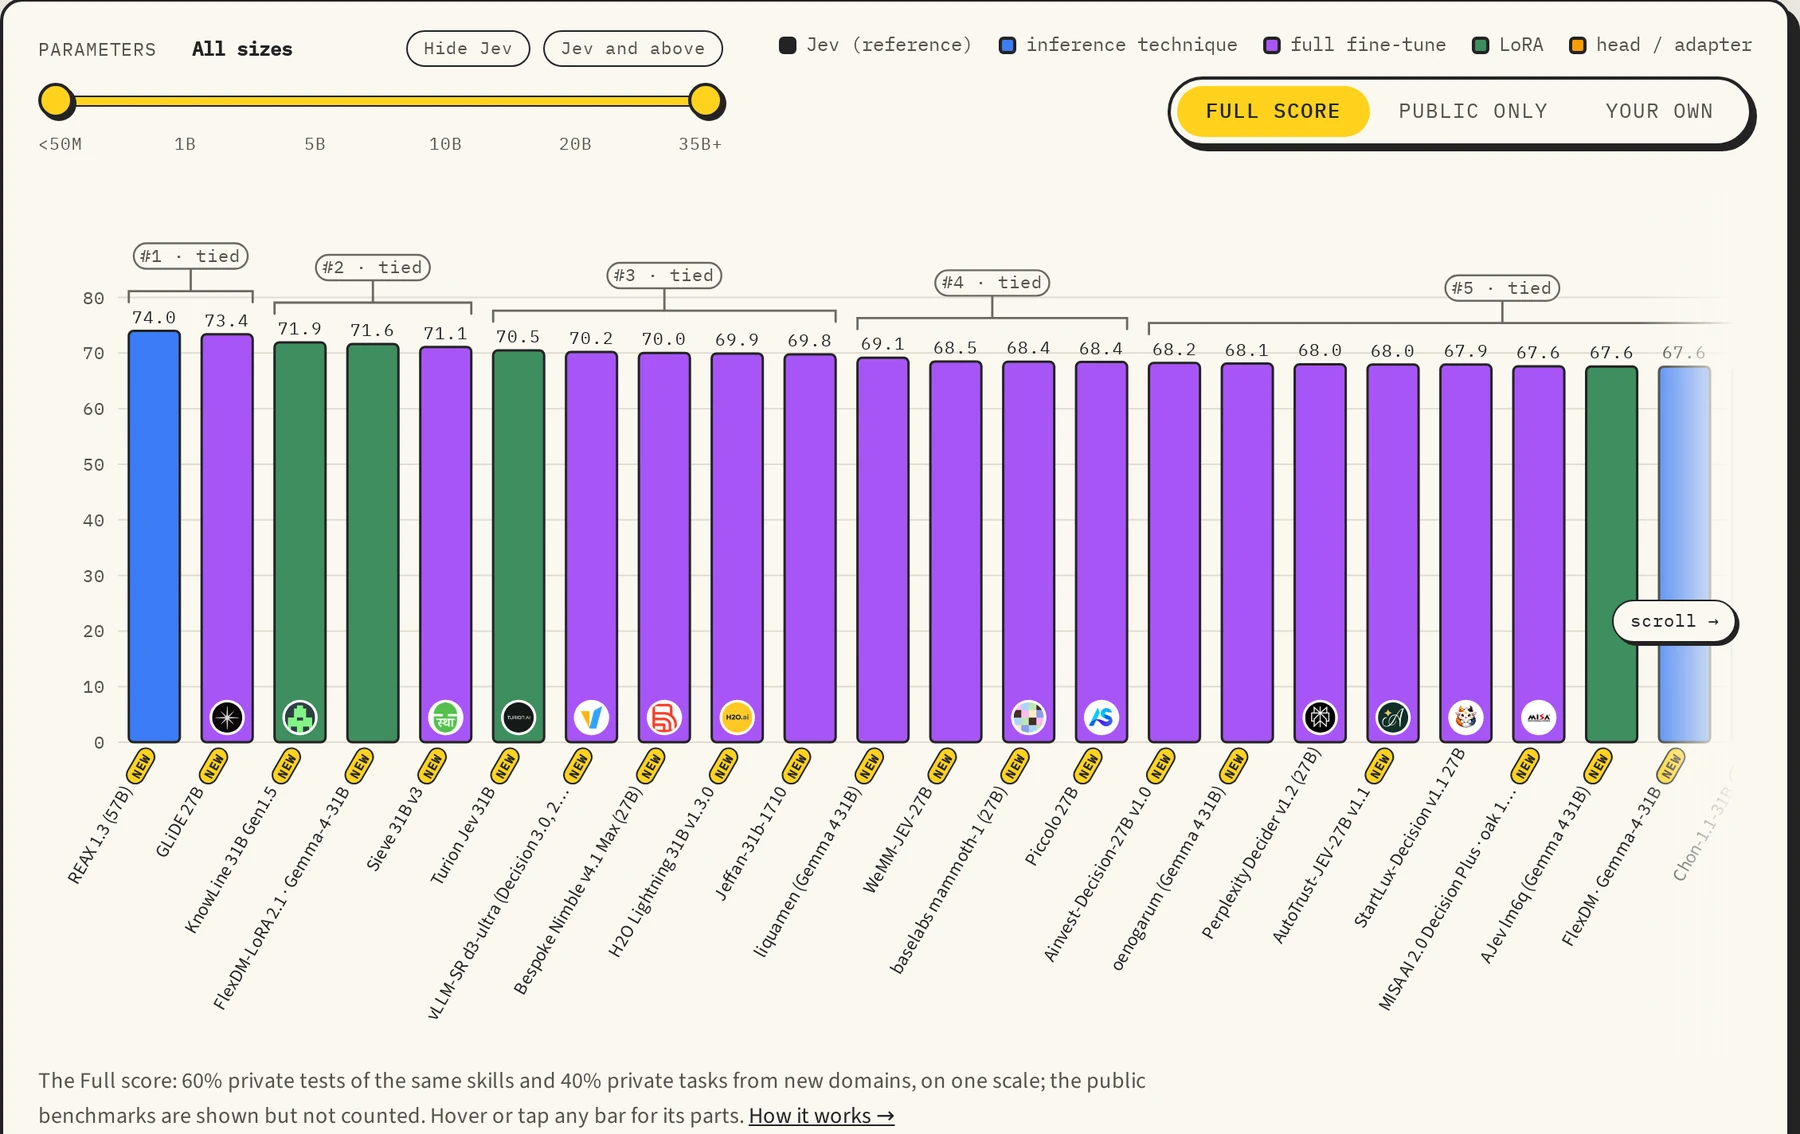
Jev가 나오고 일주일 뒤인 9월 22일, Jev Decision Index가 열렸다. TypeSafe와 관계없는 독립 리더보드이고, Jev처럼 동작하는 오픈 모델을 겨룬다. 첫 판은 같은 요청 132,422개로 오픈 모델 31개와 Jev 1.13을 함께 쟀다. 그 뒤로 판이 빠르게 바뀌어, 비공개 시험이 생기고(10월 6일) 10월 20일부터는 순위를 비공개 시험으로만 매긴다.
모델은 문서, 대화, 기기 목록 같은 상태를 받고, choice와 noul 질문에 보기마다 확률로 답한다. 규칙은 엄격하다.
- 텍스트를 생성하지 않고 한 번의 판독으로 답한다.
- RTX PRO 6000 한 장에서 지연 중앙값·평균·p80이 모두 1,000ms 이하여야 한다. 그보다 느리면 ‘더는 Jev답지 않다’며 보드에 올리지 않는다.
- 입력 자르기, 보기 줄이기, 벤치마크별 프롬프트, 시험 문항 학습은 금지다.
- 순위 점수(Full)는 공개 시험이 아니라 비공개 시험으로만 계산한다. 같은 능력을 새 데이터로 만든 ‘같은 스킬’(60%)과 처음 보는 분야의 ‘새 도메인’(40%)이다.
원조인 Jev도 같은 보드에 기준선으로 올라 있다. Jev 1.13의 Full은 59.22(같은 스킬 58.04, 새 도메인 47.72)다. Jev의 지연은 연구실에서 API를 부른 왕복 시간이라, GPU 한 장에서 잰 다른 모델과 바로 비교할 수는 없다. 11월 6일 보드에서는 274개 중 62개 출품작이 Jev보다 Full이 높고, 그중 8개는 가중치를 바꾸지 않은 추론 기법이다. 다만 Jev는 이 보드가 아니라 실제 업무 흐름을 겨냥해 만든 모델이고, 새 버전도 계속 나오고 있다.
우리가 낸 두 모델
우리는 같은 기본 모델 google/gemma-4-31B-it로 두 가지를 냈다.
- FlexDM: 가중치를 건드리지 않고 읽는 방식만 바꾼 추론 기법
- FlexDM-LoRA: FlexDM의 읽는 방식 그대로 학습한 LoRA 어댑터
| FlexDM | FlexDM-LoRA ver 2.1 | |
|---|---|---|
| 분류 | 추론 기법 | LoRA |
| Full | 67.56 | 71.61 |
| 같은 스킬 / 새 도메인 | 62.98 / 58.52 | 66.36 / 62.57 |
| 공개 지수 (0.3) | 63.63 | 68.99 |
| 보드 지연 중앙값 / 평균 / p95 (ms) | 108.6 / 300.9 / 1,106 | 155 / 416 / 1,695 |
| 순위 (11월 6일 보드, 274개) | 22위, 추론 기법 2위 | 4위, LoRA 2위 |
FlexDM은 처음 등재될 때(10월 21일) 224개 중 8위, 추론 기법 1위였다. FlexDM-LoRA ver 2.1의 새 도메인 점수는 보드 전체 2위다.
잘 된 것만 적지 않고, 해 봤다가 버린 것과 처음에 틀렸던 판단도 함께 적었다.
1. 생성하지 않고 읽는다
모델에게 답을 쓰게 하지 않는다. 일반 언어 모델로 System One 모델처럼 답하는 가장 단순한 방법이다.
프롬프트를 Answer: (에서 끝내고, 그 자리에서 다음 토큰이 각 보기 기호
(A, B, …)일 로그확률 \(\ell_i\)만 읽는다. 확률은 온도 \(T\)를 건 softmax다.
온도는 질문 유형마다 다르다. 객관식은 보기 수 \(n\)에 따라 \(T = 10.9757 - 1.7016 \ln n\), 예/아니오는 \(T = 10.732\)이다. 공개 시험 밖의 보정용 문항 절반으로 맞추고 나머지 절반으로 확인했다. 확인용 절반에서 기대 보정 오차(ECE)가 0.123에서 0.030으로 줄었다. 온도는 1등 답을 바꾸지 않으므로 정답률은 그대로이고, 확률만 정직해진다.
같이 맞춘 ‘예/아니오 치우침 보정’은 버렸다. 보정용 예/아니오 문항이 한 데이터셋에서만 나와 근거가 약했고, 공개 표본의 지수도 61.03에서 60.72로 낮췄다.
2. 질문 먼저 보여 주기
보통은 본문을 먼저 주고 질문을 뒤에 준다. 그러면 모델은 무엇을 찾아야 하는지 모르는 채로 본문을 읽는다. FlexDM은 요청에 들어 있는 질문 목록을 본문 앞에 한 번 보여 준다.
Questions that will be asked about the context:
- 질문 1
- 질문 2

Context:
<본문>

Question: 질문 1
Options:
(A) ...
(B) ...
Answer: (
공개 표본 2,000요청에서 이 배치만으로 표본 지수가 55.45에서 61.03으로 +5.6 올랐다. 기준은 보드의 ‘Decider chat’ 출품작과 같은, 본문 먼저 배치다. 질문 먼저 배치 자체는 보드의 다른 출품작에서도 이미 쓰이던 방식이다.
3. 짧은 요청은 두 번 읽기
디코더 모델은 앞의 토큰만 볼 수 있다. 그래서 처음 읽을 때 본문의 토큰은 뒤에 오는 질문과 보기를 보지 못한다. FlexDM은 3,000토큰 이하의 요청에서 사용자 입력 전체를 한 번 더 쓴다.
<질문 목록> <본문> <질문과 보기>

Read the same input again before answering:
<질문 목록> <본문> <질문과 보기>
Answer: (
두 번째 사본의 모든 토큰은 첫 번째 사본 전체를 볼 수 있다. 가중치를 바꾸지 않고 양방향으로 읽는 효과를 낸다.
- 질문 목록
- 본문
- 질문·보기
- 다시 읽기 안내
- Answer: (
두 번 읽기는 처음 만든 transformers 엔진에서도 시험했다. 표본 지수가 +3.44 올랐지만 평균 지연이 2,414ms라 규칙을 넘었다. vLLM으로 옮겨 지연에 여유가 생긴 뒤에야 다시 꺼낼 수 있었다(4장).
| 읽는 방식 (vLLM FP8, 공개 표본 2,000요청) | 표본 지수 | 지연 중앙값 / 평균 / p80 (ms, 스위트 비중 환산) |
|---|---|---|
| 본문 먼저 (기준) | 55.45 | 73 / 190 / 240 |
| 질문 먼저, 한 번 읽기 | 61.03 | 77 / 235 / 261 |
| 질문 먼저 + 3,000토큰 이하 두 번 읽기 (FlexDM) | 62.82 | 145 / 412 / 621 |
| 질문 먼저 + 6,000토큰 이하 두 번 읽기 | 62.92 | 154 / 499 / 685 |
두 번 읽기의 이득은 +1.79(90% 구간 +0.17~+3.40)였다. 한도를 6,000토큰으로 올리면 점수는 거의 그대로인데 느려져서 3,000에 멈췄다.
길이 한도는 실패에서 나왔다. 처음에는 모든 요청을 두 번 읽었다. 3시간 동안 2,000요청 중 402개밖에 끝나지 않았고, 긴 검색 요청 하나는 1,446초가 걸렸다. 같은 요청을 한 번 읽을 때보다 28배 느렸다. 원인은 프리픽스 캐시였다. 첫 번째 사본은 질문마다 다른 보기로 끝나므로, 그 뒤의 두 번째 사본은 질문마다 처음부터 다시 계산해야 한다. 질문 목록만 수만 토큰인 요청에서는 질문 수만큼 수만 토큰을 다시 계산하고 있었다. 짧은 요청은 다시 계산해도 싸서 길이 한도를 뒀다.
- 질문 목록
- 본문
- 질문·보기
- 다시 읽기 안내
- Answer: (
두 번 읽기에는 덤도 있었다. 보기 순서를 뒤집었을 때 1등 답이 바뀌는 질문의 비율이 9.19%에서 7.21%로 줄었다. 순서에 덜 흔들린다.
입력을 두 번 넣는 방법 자체도 새것은 아니다. 보드의 다른 출품작들도 이미 쓰고 있었다. FlexDM의 몫은 질문 먼저 배치 위에서 캐시가 깨지지 않게 길이 한도를 정하고, 온도와 서빙을 맞춘 것이다.
4. 빠르게 서빙하기
처음 엔진은 transformers로 질문을 하나씩 읽었다. 표본 지수는 55.08이었는데, 지연이 평균 1,820ms, p80 3,873ms로 규칙을 크게 넘었다. 질문이 수십 개 달린 요청에서 같은 본문을 질문마다 다시 읽었기 때문이다. 한 요청의 질문을 묶어 읽어도 p80이 1,190ms였다. 그래서 vLLM으로 옮겼다.
- vLLM 0.30, 불러올 때 FP8(블록 단위)로 양자화, 프리픽스 캐시. 한 요청의 질문들은 본문까지의 캐시를 함께 쓴다.
- 최대 131,072토큰. 처음 엔진에서는 34,330토큰짜리 요청이 32,768토큰 한도에 걸려 거절됐다. 거절은 0점이고 자르기는 금지라서 한도를 올렸다. 그래도 넘는 요청은 자르지 않고 처리 불가로 표시한다.
- vLLM은 Gemma의 logit 소프트캡을 건 뒤의 로그확률을 돌려준다. transformers 엔진(소프트캡 전)과 값이 달라서, ‘예’의 확률로 순위를 매기는 검색 과제의 점수가 3~4.5점 높게 나왔다. 나중에 LoRA를 학습할 때도 손실을 이 값에 걸었다.
- FP8과 bf16의 1등 답 일치율은 98.98%였다. 운영진이 비공개 시험을 다시 돌려 확인한 재현 일치율은 100.00%(831행)였다.
- 공개 스위트 전체 140,178행을 오류 없이 마쳤다. 연구실 GPU(전력 제한형 Max-Q)에서 중앙값 146 / 평균 403 / p80 534ms였고, 보드의 공식 장비에서는 108.6 / 300.9ms였다.
5. 다른 팀이 가져다 쓴 두 번 읽기
FlexDM 코드는 MIT로 공개했다. 보드에 오르고 하루 만에, 한 LoRA 출품팀(KnowLine)이 가중치는 그대로 두고 FlexDM의 두 번 읽기만 붙인 새 버전 세 개를 냈다. PR에는 “The layout follows FlexDM (MIT)”라고 밝혔다. 질문마다 따로 읽는 방식이라 요청의 94%를 두 번 읽었다. 보드에서 같은 가중치의 점수는 이렇게 바뀌었다.
| 기본 모델 | 같은 스킬 | 새 도메인 |
|---|---|---|
| Qwen 35B-A3B | +2.52 | +6.16 |
| Gemma 26B-A4B | +1.03 | +5.28 |
| 4B | +1.14 | +3.26 |
35B 모델은 Full이 61.20에서 65.77로 올라 37위에서 21위가 됐다.
우리에게는 직접 할 수 없던 실험이었다. 가중치는 같고 읽는 방식만 바꾼 비교라서, 두 번 읽기가 비공개 시험에 주는 효과를 그대로 보여 준다. 특히 새 도메인이 +3~6 올랐다.
우리 쪽 측정과는 크게 달랐다. 공개 점수에 맞춰지지 않으려고, 우리는 공개 시험 밖의 데이터셋으로 비공개 시험을 흉내 낸 채점기를 따로 만들어 쓰고 있었다. 이 채점기는 두 번 읽기의 새 도메인 효과를 +0.13으로 쟀다. 사실 이 채점기는 그보다 먼저 검증에서 떨어진 상태였다. 보드 점수가 나온 다른 Gemma LoRA의 학습 효과를 거의 재지 못했다(보드 새 도메인 +8.36, 채점기 −0.43). 그래도 같은 가중치에서 읽는 방식만 비교하는 데는 쓸 수 있다고 봤는데, 두 번 읽기의 새 도메인 효과마저 놓치고 있었다. 그 뒤로는 우리 채점기보다 보드에 쌓인 다른 출품작들의 점수를 더 믿었다.
6. 해 봤지만 효과가 없던 것
표로 보기 (점수가 없는 두 가지 포함)
| 시도 | 결과 (표본 지수, FlexDM 대비) |
|---|---|
| 확신 낮은 질문만 보기를 거꾸로 놓고 다시 읽어 평균 | −0.38 ~ −0.57 |
| 모든 질문을 두 순서로 읽어 평균 | −0.58 |
| 보기 위치 치우침 보정 | 이득 없음 |
| 보기를 한 칸씩 돌린 순서들로 평균 (확신 낮은 5~20%) | −0.25 ~ −0.62, 지연 +11~30% |
| 짧은 요청은 세 번 읽기 | −0.95 |
| 본문 없이 질문만 읽은 확률로 보기 치우침 지우기 | −0.13 ~ −0.90, 지연 +20~30% |
| 두 번째 사본을 질문끼리 공유 | −0.88 (대신 평균 지연 −26%) |
| 한 번에 처리하는 토큰 수 키우기 | 지연 변화 없음 |
맨 위의 역순 재판독은 처음에 가장 유망해 보였다. transformers 엔진에서 가장 자신 없는 5%에 쓰면 +1.42였다. vLLM으로 옮기자 +0.79가 됐고, 두 번 읽기와 맞춘 온도 위에서는 음수가 됐다. ‘5%’라는 비율을 같은 표본에서 골랐고, 역순 재판독이 고치던 몫을 두 번 읽기가 이미 가져갔다고 본다.
잡음도 생각보다 컸다. 한 번에 처리하는 토큰 수만 바꿔 다시 돌렸더니, 1등 답은 99.58% 같았는데 표본 지수가 0.5 움직였다. 그래서 0.5 안팎의 차이는 잡음으로 보고, 미리 정한 기준을 넘는 것만 채택했다. 학습 없는 모델에서는 두 번 읽기가 순서 문제를 이미 대부분 흡수하고 있었다. 이 결론은 LoRA에서 뒤집힌다(8장).
7. FlexDM-LoRA: 읽는 방식 그대로 학습하기
원칙
학습할 때의 입력을 서빙할 때와 똑같이 만든다. 질문 먼저 배치, 3,000토큰 두 번 읽기, 한 요청의 질문을 한 번에 읽기를 그대로 쓰고, 보기 순서만 질문마다 섞는다. 손실도 서빙할 때 읽는 확률 \(p_\theta\)(같은 온도)에 건다.
\[\mathcal{L} = \mathrm{CE}(y, p_\theta) + 1.0 \cdot \mathrm{KL}(p_{\text{teacher}} \,\|\, p_\theta) + 0.3 \cdot \mathrm{Brier}(y, p_\theta)\]선생님 \(p_{\text{teacher}}\)는 다른 모델이 아니라 얼린 기본 모델 자신이다.
- 대부분의 문항: 기본 Gemma를 FlexDM으로 읽은 분포, 정순과 역순 평균. 어댑터를 기본 모델 곁에 묶어 둔다.
- 계산·추론 문항(v2.0부터): 기본 Gemma가 생각 모드로 푼 답의 분포. 서빙에서는 생각하지 않으므로, 생각해서 얻는 이득을 한 번의 판독으로 옮기는 셈이다.
LoRA는 rank 64, 7개 투영 전부, dropout 0, 학습률 1e-4, 1 epoch이다.
강도
학습한 변화를 전부 쓰지 않는다. 가중치에 \(W' = W + s\,\Delta W\)로 더하고, 강도 \(s\)는 미리 정한 규칙으로 고른다. 첫 학습에서 이유를 알았다.
- 1만 문항만 학습한 시범 어댑터는 공개 표본 +0.42였다.
- 9만 문항 전체를 약 31시간 학습하자 오히려 −0.66이 됐다. 일부 과제가 망가졌다. POP909 화음 판정은 48.3에서 22.5로, 피싱 메일 판정은 94.9에서 74.4로, 집안 기기 제어는 80.0에서 62.5로 떨어졌다.
- 같은 어댑터를 강도 0.5로 쓰자 +1.29, 지식·추론 다섯 과제 평균은 +3.58이 됐다. 기기 제어 같은 과제는 FlexDM 수준으로 돌아왔지만, 피싱 메일 판정은 여전히 낮았다(8장).
위의 과제별 숫자는 과제당 40문항쯤에서 잰 것이라 많이 흔들린다. 강도 0.5에서 POP909가 −9로 보였는데, 1,000문항으로 다시 재니 +2~3이었다. 그 뒤로는 중요한 과제를 과제의 전체 문항으로 다시 쟀다.
접은 길
- 벤치마크 학습 분할: 공개 시험의 공식 학습 분할(시험 분할이 아닌 것)을 3만 6천 문항 더 넣는 학습을 시작했다가 중간에 멈췄다. 보드를 보니 학습 분할에 기댄 다른 Gemma LoRA들은 새 도메인이 학습 전보다 2.6~3.5 떨어져 있었다. ver 2.1에서도 학습 분할은 전체의 1.6%뿐이다.
- 서두른 학습: ver 1.0 다음 학습을 한 번 시작했다가 3분 만에 멈췄다. 넓은 데이터의 출처당 문항이 너무 적었고, 생각 모드 라벨도 아직 없었다. 그 뒤로는 데이터 준비가 모두 끝난 뒤에만 본 학습을 시작했다.
버전
| ver 1.0 | ver 2.0 | ver 2.1 | |
|---|---|---|---|
| 학습 문항 | 90,007 | 115,249 | 180,101 |
| 평균한 학습 | 1 | 1 | 2 (seed 0, 1) |
| 서빙 rank / 강도 | 64 / 0.5 | 64 / 0.5 | 128 / 0.7 |
| 확신 낮은 질문 역순 재판독 | 없음 | 있음 | 있음 |
| 공개 지수 (0.3) | 65.47 | 66.49 | 68.99 |
- ver 1.0: 사람이 라벨을 단 공개 데이터와 코드로 정답을 계산하는 합성 과제.
- ver 2.0: 폭을 넓혔다.
- tasksource의 상업 사용 가능 출처 359개
- 생각 모드 라벨을 단 지식·추론 학습 분할
- 기본 모델이 직접 쓴 문서와 질문
- 키트의 시뮬레이터 규칙으로 만든 기기 제어 문제
- 공개 시험에 없는 곡의 POP909 화음 문제
- ver 2.1: ver 2.0에서 약했던 형식을 메웠다.
- 기본 모델이 직접 쓴 상품 리뷰 744개와 피싱·정상 메일 1,458개
- 코드로 만든 인과 그래프 문제와 가상 임상시험 문제
- API-Bank의 API 정의로 만든 ‘다음에 부를 API’ 문제
- 같은 데이터·설정으로 seed만 바꿔 두 번 학습해 평균
모든 학습 행은 공개 시험 140,620행과 정확 일치, 8-gram, 긴 공통 구간, 짧은 줄 퍼지 비교로 대조해 겹치는 것을 뺐다. 다른 참가작의 출력은 쓰지 않았다.
8. LoRA에서 배운 것
생각 모드 선생님은 한 번의 판독으로 옮겨진다. 생각 라벨 1만 800문항만으로 시험 학습을 해 보니, 학습에 쓰지 않은 800문항에서 정답률이 80.6에서 84.8(+4.1, 90% 구간 +2.4~+5.9)로 올랐다. 계산 문항은 +9.2였다. 다만 이 시험 학습에는 정답 CE도 들어 있어서, 생각 라벨만의 몫은 나누지 못했다.
학습은 ‘아니오’ 쪽으로 쏠림을 심는다. ver 2.0은 피싱 메일 판단이 크게 나빠졌다. 미리 정해 둔 선택 규칙으로는 고를 후보가 없었다. 다른 과제가 크게 올라서, 피싱의 바닥 기준 하나만 예외로 하고 냈다.
원인은 바로 보이지 않았다. 피싱 문제를 학습한 적은 없었다. 처음에는 선생님을 의심했지만, 기본 모델의 정순·역순 평균은 피싱 점수를 바꾸지 않았다. 놓친 메일을 모아 보니 피싱을 정상으로 보는 쪽이었다. 내용은 그럴듯하지만, 개인 웹메일이 공유 문서 링크로 자료를 요청하는 식으로 호스팅이 수상한 메일들이었다. 결국 범인은 스팸·유해성 판정 출처였다. 이 출처들에는 ‘해롭지 않음’ 정답이 기본 모델보다 많았고, 그것이 모든 예/아니오 판단을 ‘아니오’ 쪽으로 밀었다. ver 2.1에서는 다음 두 가지를 했다.
- 그런 출처의 부정 정답 287행을 빼서 비율을 기본 모델에 맞췄다.
- 직접 쓴 피싱·정상 메일을 넣었다. 정상 메일에는 공유 문서 링크나 개인 웹메일 발신자를 넣지 않았다.
우리 과제 세트에서 피싱 판단은 FlexDM 대비 −15.2에서 +5.0이 됐다.
순서 평균은 학습한 모델에서 다시 쓸모가 생긴다. 학습 없는 FlexDM에서는 효과가 없던 ‘확신 0.6 미만인 질문만 보기를 거꾸로 놓고 다시 읽어 평균’이, 학습한 어댑터에서는 이득이었다. 학습이 셀수록 이득도 컸다. 학습이 보기 위치나 라벨 쪽의 버릇을 만들고, 반대 순서가 그 버릇을 지운다고 본다. 확신 낮은 질문만 다시 읽으므로 지연은 조금만 늘어난다. ver 2.0부터 넣었다.
두 학습의 평균은 rank를 이어 붙이면 정확하다. 두 LoRA(\(\Delta W_k = B_k A_k\), 각 rank 64)를 이어 붙이면 변화가 정확히 평균인 rank 128 LoRA 하나가 된다.
\[\tfrac{1}{2} B_0 A_0 + \tfrac{1}{2} B_1 A_1 = \begin{bmatrix} \tfrac{1}{2} B_0 & \tfrac{1}{2} B_1 \end{bmatrix} \begin{bmatrix} A_0 \\ A_1 \end{bmatrix}\]- seed 0
- seed 1
병합하지 않은 어댑터 그대로 vLLM에 올릴 수 있다.
vLLM에서는 v_proj를 복사해야 한다. Gemma 4의 전역 어텐션 10개 층에는 v_proj가 없고, V가 k_proj의 출력이다.
transformers에서는 k_proj LoRA가 K와 V를 함께 바꾸지만, vLLM은 V 쪽에 LoRA를 따로 둔다. 서빙용 사본에서는 이 층들의
k_proj LoRA를 v_proj로도 복사한다. 이것을 빼먹으면 오류도 없이 학습한 변화의 일부가 조용히 사라진다.
9. 보드 점수 미리 맞히기
비공개 점수는 제출하고 며칠 뒤에야 나온다. 그래서 공개 점수로 비공개 점수를 미리 추정해 두고 결과를 기다렸다. ver 2.1의 추정은 71.60, 실제는 71.61이었다.
다만 실력만은 아니다. 같은 스킬은 0.69 낮게, 새 도메인은 0.88 높게 빗나갔고, 둘이 서로를 상쇄했다. 같은 방식으로 보드의 다른 출품작들을 추정해 보면 실제보다 평균 2점쯤 높게 나왔으니, 이번에 딱 맞은 데는 운도 섞였다.
10. 다음
- 왜 질문 먼저 + 두 번 읽기가 효과가 있는지, attention이 어디로 가는지 들여다보는 분석
- 순서를 바꿔도 같은 답을 내는 모델
- 같은 점수를 더 빠르게 내는 서빙
링크
- 코드 (FlexDM, MIT): github.com/1000luca/FlexDM
- 어댑터 (CC BY-SA 4.0): ver 2.1, ver 2.0, ver 1.0
- 공개 시험 결과: FlexDM, FlexDM-LoRA ver 2.1
- Jev: TypeSafe의 발표 글, 독립 평가 논문 (arXiv 2609.37647)
- 리더보드: multimodalart/jev-decision-index, 평가 키트: apolinario/decision-index